第6章 联邦迁移学习
本章先记住
- 特征相同优先考虑HFL;共同样本足够多优先考虑VFL;两者都不满足且存在可迁移语义时才考虑FTL。
- FTL同时优化任务监督、跨域表征对齐和模型正则化。
- 对齐距离下降不代表迁移有效;必须用B-only目标域对照检查负迁移。
🧭 学习目标与本章地图
本章定位
- 在知识体系中的位置:三类联邦学习算法主线的第三章,处理样本和特征都难以充分对齐的异构协作。
- 前置知识:迁移学习、神经网络表征、VFL、安全计算、AHE和秘密共享。
- 后续基础:跨域联邦、多模态联邦、弱监督联邦和联邦表征学习。
- 核心问题:只有少量共同样本、特征空间又不同,如何利用源域标签帮助目标域预测,并控制共享表征的泄露?
学习目标
- 解释何时HFL/VFL都不适用而需要FTL。
- 区分基于实例、特征和模型的联邦迁移。
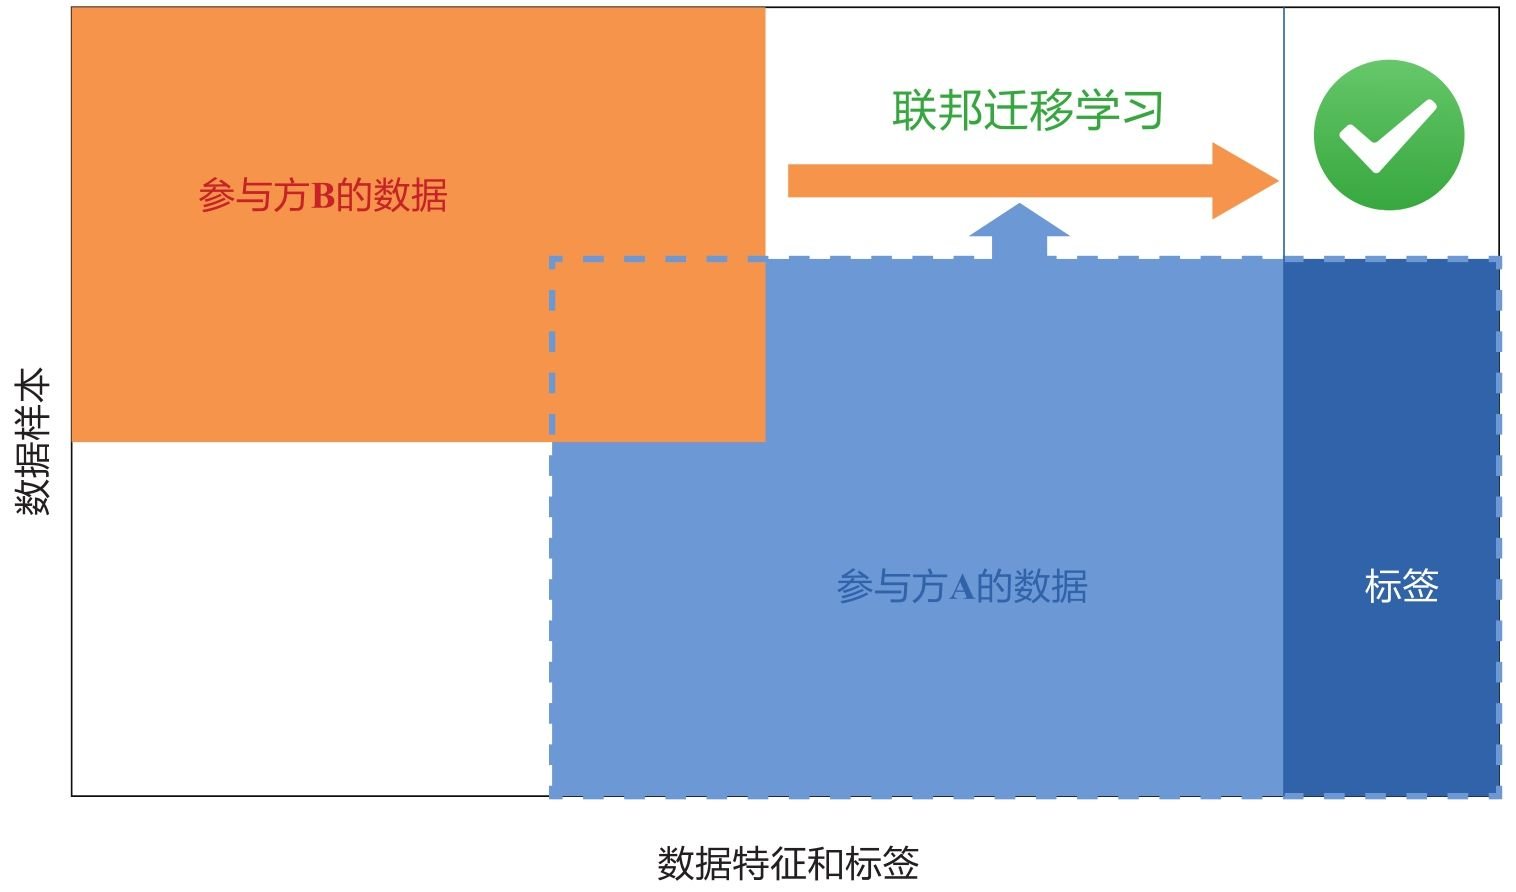
- 重建典型的两方特征型FTL数据与角色设置。
- 解释监督损失、对齐损失和正则项各自作用。
- 比较AHE版与秘密共享版训练/预测流程。
- 识别负迁移、恶意输入和共享表征泄露风险。
Mermaid思维导图
一、本章要解决的问题
HFL要求特征空间足够一致,VFL要求样本空间有大量重叠。现实中的跨地区银行、不同业务平台或不同模态机构可能同时存在:
- 共同用户少;
- 共同特征少;
- 数据分布和规模差异大;
- 目标方标签很少甚至没有。
FTL不再直接平均同构模型或拼接大量共同样本,而是寻找源域与目标域之间可迁移的不变性。本章采用一个典型的特征型两方框架:用少量共同样本让两方神经网络的隐藏表征对齐,再借助源域标签预测目标域未标注样本。
⚡ 易混淆点
“存在相关性”不等于“迁移一定有益”。若对齐样本不代表目标域、任务语义不同或对齐权重过大,共享表征会产生负迁移,使目标域性能低于B-only目标域对照。
二、核心概念与定义
| 概念 | 准确定义 | 通俗理解 | 与相近概念的区别 |
|---|---|---|---|
| 源域 | 数据或监督相对丰富、提供可迁移知识的领域 | 知识提供方 | 不保证规模总是更大,关键是提供监督/知识 |
| 目标域 | 希望改善预测、但数据或标签不足的领域 | 知识接收方 | 最终评价主要在目标域 |
| 联邦迁移学习(FTL) | 在数据不能集中且需隐私保护时,跨样本/特征异构领域迁移知识 | 安全地跨域借知识 | 传统TL通常可直接访问双方数据/模型 |
| 基于实例的迁移 | 选择或重加权源/目标样本以缩小分布差异 | 挑选更像目标域的样本 | 不直接规定共享表征或模型结构 |
| 基于特征的迁移 | 学习使不同领域语义可比较的共同表征 | 把不同字段映射到同一种语言 | 本章重点展开的方法 |
| 基于模型的迁移 | 共享模型、参数或预训练模型作为迁移载体 | 迁移模型知识 | HFL也可被视为一种广义模型迁移 |
| 对齐损失 | 约束共同样本在两方隐藏空间相似的损失 | 同一个人在两个表示中靠近 | 与有标签监督损失作用不同 |
| 负迁移 | 迁移后目标性能反而下降 | 借来的知识带偏目标模型 | 不能只通过训练损失判断 |
狭义FTL通常用三种空间均不同来刻画异构场景:
其中
三、三类联邦迁移
在HFL中重加权不同分布的样本;在VFL/异构场景中筛除可能造成负迁移的样本或特征。难点是如何在不查看对方数据时估计相似度和权重。
| 类型 | 迁移载体 | 所需联系 | 主要风险 |
|---|---|---|---|
| 实例 | 样本选择/权重 | 可估计样本相关性 | 权重泄露、选择偏差 |
| 特征 | 隐藏表征 | 少量对齐样本或分布约束 | 表征泄露、语义错配 |
| 模型 | 参数/结构/预训练模型 | 任务和模型可复用部分 | 模型不兼容、负迁移 |
四、典型两方框架的数据与角色
设源域A持有:
目标域B持有未标注数据:
双方有少量共同样本对:
A还保管少量与B方目标样本对应的授权标签。记其索引—标签集合为:
其中
两方本地网络生成
其中网络参数分别为
贯穿案例C:跨地区弱标签迁移
设A是监督信息较丰富的源地区机构,B是字段体系不同、可用监督稀缺的目标地区机构;双方只有少量可配对对象。
| 统一问题 | 本案例的回答 |
|---|---|
| 参与方是谁? | 源域A与目标域B;两方分别训练自己的表征网络 |
| 数据如何分布? | A有 |
| 交换什么? | 加密或秘密共享的表征交互项、联合损失和双方梯度 |
| 谁能看到什么? | 各方保留本地数据与网络;按协议看到密文/份额、受掩码梯度和授权预测 |
| 模型归谁? | 两个本地网络分别归A、B持有,联合预测函数依赖双方组件 |
| 推理依赖谁? | 本章协议通常需要A、B协作;若要单方部署,需要另做蒸馏或模型迁移 |
| 哪个假设最脆弱? | 少量对齐样本确实代表跨域关系,且两域共享的语义有助于B方任务 |
| 与谁比较? | B-only目标域对照、 |
五、关键公式
5.1 与目标域样本对应的监督损失
对
利用A方知识和B方表征生成目标预测。 是监督损失;以Logistic损失为例:
- 记
;该项要求目标预测能解释授权标签。若 太小,单独优化容易过拟合。
5.2 表征对齐损失
共同样本的表征对齐损失为:
5.3 联合目标
将监督、对齐和正则项组合为联合目标:
其中:
控制迁移/对齐强度。 控制模型复杂度。 - 增大
通常加强两域耦合,但域差异大时增加负迁移风险。 - 增大
抑制过拟合,但可能降低表征能力。
💡 把三个损失翻译成直觉
:把目标任务做对,让B方表示能够解释已有标签。 :让两个领域说同一种表示语言,约束共同样本的隐藏表示接近。 :避免模型过度复杂,减少仅记住少量对齐样本的风险。
若
💡 贯穿案例C:对齐权重如何改变模型选择
假设训练产生两个候选模型,正则项贡献都为
| 候选模型 | 监督损失 | 对齐损失 | 直觉 |
|---|---|---|---|
| P:任务优先 | 目标预测较好,但两域表示不够接近 | ||
| Q:对齐优先 | 两域表示很接近,但监督任务较差 |
当
目标函数会选择P。令两者总损失相等,可以得到切换点:
当
如果目标域独立测试集上,B-only损失为
这些数值用于展示权重的决策作用,不代表真实损失必然处于该范围。实际实验应扫描
,同时报告监督损失、对齐距离和目标域泛化性能。
对
该梯度把监督信号、跨域对齐信号和正则化对应到同一反向传播过程。
5.4 安全计算中的近似
一种AHE实现会对最终损失相关表达采用二阶泰勒近似,使计算适配加法和标量乘法。近似误差来自最终损失表达,而不是每个神经网络激活层,因为两方网络内部仍在本地明文执行。
⚡ 精度声明边界
“只近似最终损失”不等于误差对所有数据、网络和参数都很小。近似误差取决于展开点、Logit范围和训练轨迹,应与非加密原目标逐轮比较。
💡 AHE 联邦迁移与秘密共享 FTL 的完整算法卡见 09 算法卡片。
六、AHE与秘密共享总对比
| 维度 | AHE版 | 秘密共享版 |
|---|---|---|
| 数据表示 | 密文 | 秘密份额 |
| 线上计算 | 密码运算较重 | 算术通常较轻 |
| 精度 | 该AHE实现含二阶近似 | 秘密共享算术无需该近似 |
| 离线阶段 | 密钥准备 | 大量乘法三元组 |
| 通信模式 | 密文膨胀 | 多轮份额交互 |
| 关键假设 | 加密安全、密钥管理 | 腐败阈值、非串谋、预处理安全 |
七、关键假设
| 假设类型 | 具体假设 | 假设不成立时的后果 |
|---|---|---|
| 数据假设 | 两域存在可迁移相关性 | 负迁移,B-only反而更优 |
| 数据假设 | 少量对齐样本足以约束共同表征 | 对齐不可识别或过拟合交集 |
| 系统假设 | 双方训练/推理时稳定在线 | 协议和预测中断 |
| 模型假设 | 两方隐藏表征维度和交互函数兼容 | 无法计算对齐损失 |
| 信任假设 | 双方半诚实,最多一方被破坏 | 恶意输入可探测表征或破坏模型 |
| 攻击者假设 | 密钥/份额和随机掩码正确管理 | 梯度、中间量或输入可泄露 |
八、代价与权衡
| 维度 | 收益 | 代价或风险 |
|---|---|---|
| 模型效果 | 弱标签目标域可借助源域 | 负迁移与对齐样本偏差 |
| 本地计算 | 原始特征和网络留在本地 | 双网络训练、HE/MPC额外计算 |
| 通信成本 | 只交换受保护中间量 | 高频密文/份额交互 |
| 存储成本 | 模型分散持有 | 密钥、份额、三元组和协议状态 |
| 隐私保证 | 控制输入和中间量可见性 | 输出、表示和梯度仍可能泄露 |
| 安全与鲁棒性 | 可限制半诚实单方所见信息 | 基础协议不处理恶意方 |
| 客户端公平性 | 双方共同得到目标模型价值 | 源域贡献、目标域收益难定价 |
九、复习与推演
- 哪些数据条件下HFL和VFL都不足以工作?
- 基于实例、特征、模型的迁移载体分别是什么?
- 典型两方FTL中A、B各持有什么数据?
、 和正则项分别解决什么? - 增大
为什么可能引起负迁移? - AHE版的随机掩码和加密分别防什么?
- 秘密共享版为何线上更快却需要离线材料?
- 如何实验证明迁移是否真正有益?
- 贯穿案例C中,候选模型P与Q在什么
处具有相同训练目标?为什么不能仅凭训练目标选择Q?
🔍 参考答案
- 样本和特征重叠都很少,目标方标签又不足。
- 分别是样本权重/选择、共同隐藏表征、参数或预训练模型。
- A持有源域特征和标签,B持有目标域未标注特征,双方有少量对齐样本。
- 监督目标预测、跨域表征对齐、控制模型复杂度。
- 域语义不一致时,强迫表征接近会删除目标域有用特征。
- 加密防传输/计算中直接见明文;掩码防协议对方得到确切梯度。
- 份额算术较轻,但乘法需预生成Beaver三元组等材料。
- 与B-only目标域对照、集中迁移参考和
无对齐版本在目标域同一测试集、同一计算预算下比较。 - 临界值为
;更大的 会让目标偏好对齐更好的Q,但Q在独立目标域测试集上的损失 高于B-only的 ,属于负迁移。
🧪 从理解到研究(进阶)
已知局限与隐含假设
需要学习能捕捉参与方不变性的可迁移知识;
需要在本地模型自主性与泛化之间平衡;
共享表征必须在分布式环境中被安全学习;
FTL交互频率和数据规模较大,需要高效安全协议。
少量共同样本代表跨域关系;
两域共享的潜在语义可由固定维度表征捕捉;
对齐越好通常越利于目标预测;
半诚实模型足以描述参与行为;
协同推理的长期依赖可接受。
从假设推导:
- 对齐损失可能把领域特有且有用的信息错误抹平;
- 少量重叠样本上的相关性不保证适用于B方全部样本;
- 隐藏表征不是匿名数据,可被属性推断或重建;
- A方控制标签和停止信号,双方信息与控制权不对称。
失效条件实验
本节只列FTL特有扰动;域划分、目标域对照、独立重复与结果指标统一按实验规范报告。
- 从同类到无关任务逐步降低域相似度;
- 让对齐样本只来自高活跃或特定标签群体;
- 扫描
并同时测对齐距离与目标性能; - 构造特殊非零输入探测对方表征;
- 改变表征维度、标签量和重叠样本数;
- 比较AHE近似目标和原目标的梯度夹角。
- 文献佐证:负迁移指引入源域知识后目标域性能反而低于目标域单独训练;域差异、源知识质量和迁移方法不匹配都可能触发它(Zhang et al., A Survey on Negative Transfer, 2022,arXiv:2009.00909)。Yang et al.(ACM TIST 2019,arXiv:1902.04885)给出FTL分类与共享表征框架,但不应被当作负迁移结论的直接出处。
可证伪的研究问题
当共同样本来自目标域的高活跃子群时,统一表征对齐是否会降低目标域低活跃子群的性能,而按对齐可信度加权能否在不降低总体AUC的情况下缩小群体差距?
- 现有方法:统一
的基于特征FTL。 - 失效条件:重叠样本有选择偏差。
- 可能机制:对齐目标只代表高活跃子群。
- 可观察结果:各群体表征距离、梯度方向和目标预测。
- 验证指标:总体/分群AUC、最差群体性能、负迁移率和额外协议成本。
现代研究方向
- 联邦域适应、跨模态和基础模型表征迁移;
- 自动检测和抑制负迁移;
- 无/极少样本重叠下的可识别迁移;
- 恶意安全、表示级DP和可验证对齐;
- 参数高效迁移与协同推理降本。
十、章节关系
第5章VFL:大量样本对齐、特征不同
  ↓ 减少样本重叠并引入迁移
第6章FTL:少量样本与特征重叠
  ├─ 第2章AHE/秘密共享 → 安全损失与梯度
  ├─ 第8章跨行业应用 → 弱标签与异构数据
└─ 现代研究 → 域适应、多模态、参数高效迁移原始论文与关键后续
- Yang et al., Federated Machine Learning: Concept and Applications, ACM TIST 2019(arXiv:1902.04885):FTL 在 HFL / VFL / FTL 分类中的定位出处。
- Li & Wang, FedMD: Heterogenous Federated Learning via Model Distillation, 2019(arXiv:1910.03581):模型蒸馏型联邦迁移的代表工作。
- Zhang et al., A Survey on Negative Transfer, IEEE/CAA Journal of Automatica Sinica, 2022(arXiv:2009.00909;DOI: 10.1109/JAS.2022.106004):负迁移定义、诱因与缓解方法综述。
- Gretton et al., A Kernel Two-Sample Test, JMLR 13, 2012:核最大均值差异(MMD)出处,分布距离度量的基础。