第7章 联邦学习激励机制
本章先记住
- 贡献评估回答“创造了多少价值”,收益分配回答“预算如何支付”,两者不是同一问题。
- FLI综合当前贡献、成本、历史欠偿和等待时间分配有限预算。
- FLI不负责证明贡献真实、成本诚实,也不自动满足抗女巫、抗串谋或激励相容。
🧭 学习目标与本章地图
本章定位
- 在知识体系中的位置:从“算法能否训练”转向“参与方为何持续贡献”,补足联邦学习的经济与治理条件。
- 前置知识:FedAvg训练轮次、边际贡献、收益分配、基本博弈论与队列思想。
- 后续基础:跨机构联盟治理、数据定价、贡献评估、客户端选择和长期参与。
- 核心问题:预算有限时,如何按贡献、成本和等待时间动态分配收益,并避免长期欠偿集中在少数参与方?
学习目标
- 区分平等、边际收益、边际损失和Shapley分配。
- 解释为什么只按模型改进支付仍不充分。
- 重建FLI中的
四个量。 - 解释预算不足时分期付款如何更新。
- 说明贡献评估和成本申报为何是机制的薄弱环节。
- 设计可检验激励相容性与长期公平的实验。
Mermaid思维导图
一、本章要解决的问题
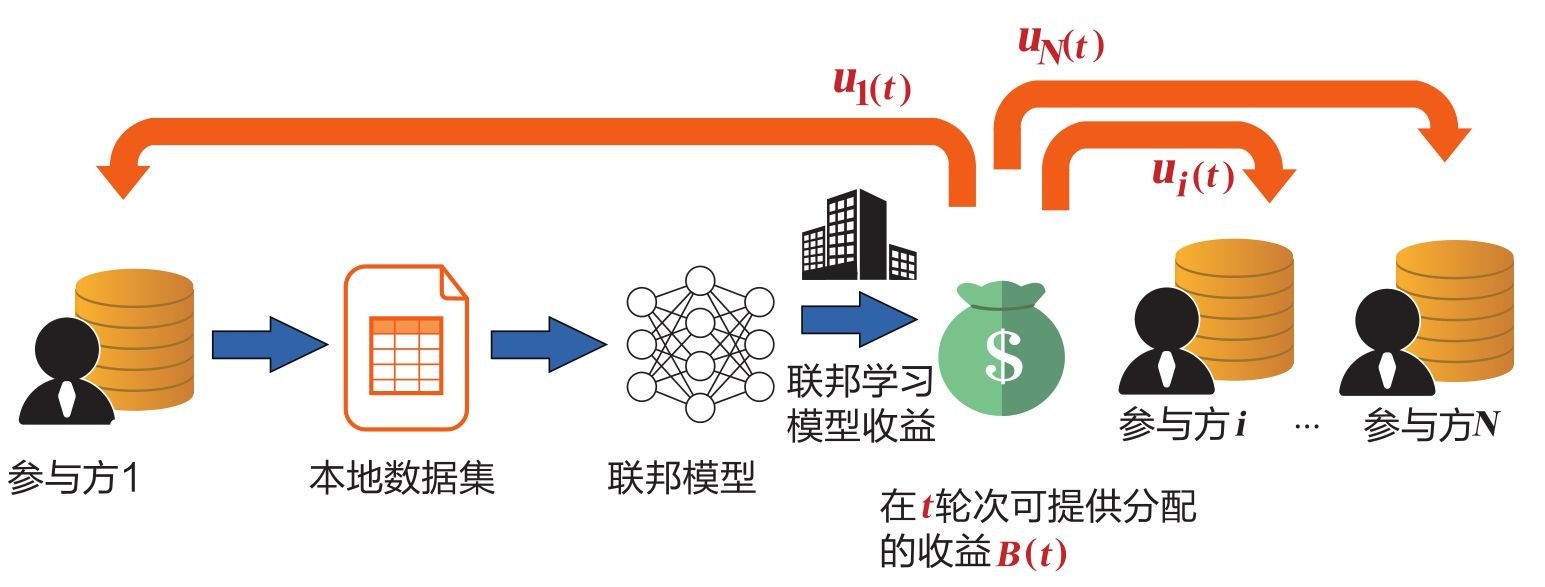
联邦模型的性能依赖参与方持续上传更新,但参与会消耗计算、通信、数据资产和商业机会。大机构可能贡献高质量数据,却因共享模型帮助竞争者而承担更高机会成本;小参与方又可能因长期得不到补偿而退出。
激励机制必须同时回答:
- 谁贡献了多少有效价值?
- 参与方付出了什么成本?
- 当前预算不足时,谁应优先得到补偿?
- 如何避免只奖励大参与方或只奖励最早参与者?
- 如何防止无信息更新、虚报和搭便车?
⭐ 核心结论
贡献评估和收益分配是两个不同问题。FLI主要解决“给定贡献分数和成本后怎样动态分配预算”,并不自动保证贡献分数真实、成本申报诚实或参与策略激励相容。
来源边界
本章的FLI特指Yu等人提出的Federated Learning Incentivizer:它在给定预算下同时考虑集体效用、未获支付和等待时间。原文把“应获补偿与已支付之间的累计差额”称为regret,本章统一译为“欠偿”,避免与机器学习损失混淆。FedCoin是另一种基于Shapley值和区块链共识的点对点支付系统,不是本章的双队列动态支付机制。
二、核心概念与定义
| 概念 | 准确定义 | 通俗理解 | 与相近概念的区别 |
|---|---|---|---|
| 效用函数 | 参与方集合 | 某组参与方一起能创造多少收益 | 不一定只等于模型精度 |
| 边际收益 | 参与方加入已有集合后增加的效用 | 加入后多带来多少 | 依赖加入顺序和已有成员 |
| 边际损失 | 参与方离开集合后减少的效用 | 缺少它会损失多少 | 依赖退出时的联盟状态 |
| Shapley值 | 对参与方在所有加入顺序中的边际贡献取加权平均 | 平均所有组队顺序下的贡献 | 概念公平但精确计算昂贵 |
| 反向拍卖 | 参与方报价提供资源,联盟选择满足质量/预算的组合 | 卖方竞价、买方采购 | 报价真实性需机制保证 |
| 贡献 | 第 | 本轮模型改进价值 | FLI将其作为外部输入 |
| 成本 | 参与方本轮贡献所需补偿的代价 | 数据、计算和机会成本 | 自报成本未必是真实成本 |
| 欠偿 | 应补偿与已支付之间的累计差额 | 还欠参与方多少钱 | 原文称regret,不是机器学习损失 |
| 时间队列 | 对未补偿状态持续时间的累计惩罚 | 欠得越久优先级越高 | 与欠款金额 |
符号速记
三、收益分配方法
预算在所有参与方间均分。简单且低成本,但忽略数据质量、规模、成本和边际价值。
| 方法 | 公平依据 | 主要优势 | 主要风险/成本 |
|---|---|---|---|
| 平等 | 身份平等 | 搭便车,不反映贡献 | |
| 单独效用 | 易解释 | 忽略互补性和冗余 | |
| 固定顺序边际 | 体现增量价值 | 顺序偏差 | |
| Shapley | 所有顺序平均边际 | 考虑互补与冗余 | 指数级联盟评估 |
| 边际损失 | 衡量不可替代性 | 退出顺序和联盟状态敏感 |
预算按效用权重分配
按支付权重划分预算:
其中
- 权重只决定预算比例,不保证预算足以完全补偿。
- 若所有
为零,实现必须定义兜底规则,否则会出现零分母。 - 预算比例化会耦合参与方:一方权重增大,其他方当轮付款减少。
Shapley贡献
对参与方全集
是尚不包含 的子联盟。 - 它平均不同加入顺序中的边际增益。
- 精确计算需评估大量子联盟;在FL中每次
可能还意味着重新训练或至少重新评估模型。
四、FLI核心机制
评估本轮贡献qi(t)与成本ci(t)
  ↓
读取历史欠偿Yi(t)与等待Qi(t)
  ↓
计算目标支付权重ui(t)
  ↓
按权重划分当轮预算B(t)
  ↓
实际支付ûi(t)
  ↓
更新欠偿和等待队列
  ↓
进入下一轮- 输入:预算
、贡献 、成本 、历史队列 、权衡参数 。 - 角色:联盟/机制管理者和
个参与方。 - 参与方状态:贡献、报价、已收收益。
- 管理者状态:贡献分数、成本、欠偿和等待队列。
- 交换信息:更新、贡献验证结果、成本报价和付款。
- 输出:每方当轮实际支付
及更新后的队列。
五、关键公式
5.1 欠偿队列
欠偿队列按成本和实际付款更新:
增加欠偿,实际付款 减少欠偿。 max保证队列非负,超额支付不形成负债倒置。大表示长期补偿不足。
5.2 时间队列
等待队列及其增量定义为:
其中
5.3 三种公平
| 公平标准 | 含义 | 对应状态 |
|---|---|---|
| 贡献公平 | 回报应与贡献 | 效用项 |
| 欠偿分布公平 | 各方欠偿和等待应尽量小且不集中 | |
| 期望公平 | 欠偿随时间的变化应尽量小 | 队列漂移 |
用长期效用衡量多轮贡献价值:
以及Lyapunov函数:
在价值和队列漂移之间权衡。
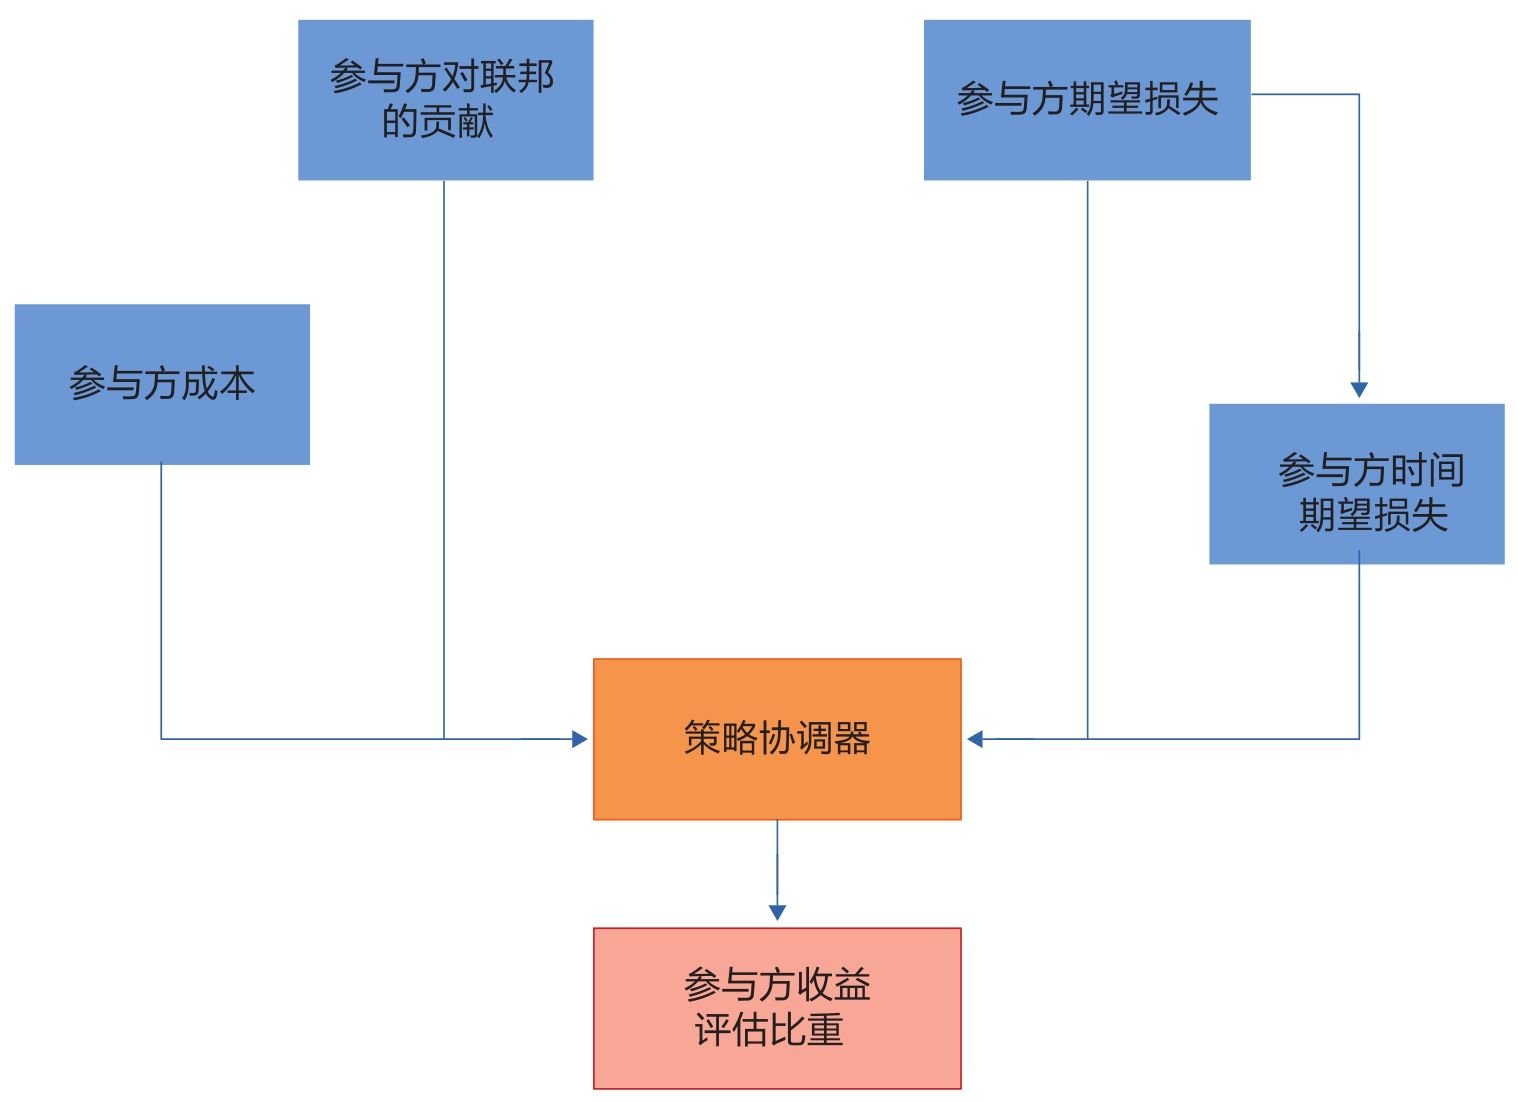
5.4 FLI支付权重
综合当前贡献、成本与历史队列,可得到支付权重:
再按支付权重对预算进行比例分配:
高:奖励有价值贡献。 高:补偿本轮成本。 高:优先偿还欠款和等待。 - 权重公式并不验证
是否真实。
💡 两个参与方的一轮支付
设
若当轮预算
💡 FLI 完整算法卡(符号、消息、终止与失效条件)见 09 算法卡片。
六、关键假设
| 假设类型 | 具体假设 | 假设不成立时的后果 |
|---|---|---|
| 数据假设 | 模型效用可被可靠度量 | |
| 系统假设 | 沙盒或反事实评估可执行 | 贡献评估过慢或不可复现 |
| 模型假设 | 单一效用指标能表达联盟价值 | 公平、安全或群体性能被忽略 |
| 信任假设 | 管理者正确记录队列和支付 | 可定向欠付或操纵权重 |
| 攻击者假设 | 参与方不通过报价、身份或更新操纵机制 | 女巫、串谋、投机更新获取超额收益 |
七、代价与权衡
| 维度 | 收益 | 代价或风险 |
|---|---|---|
| 模型效果 | 奖励有效更新可提高质量 | 对验证集过拟合或短期改进投机 |
| 本地计算 | 补偿资源投入 | 成本难审计,弱设备可能被排除 |
| 通信成本 | 可将通信纳入成本 | 报价和评估增加协议复杂度 |
| 存储成本 | 队列仅线性状态 | 长期审计和支付记录需治理 |
| 隐私保证 | 可用收益换参与 | 贡献评估可能泄露数据价值和分布 |
| 安全与鲁棒性 | 无信息更新可不奖励 | 付款指标本身成为攻击目标 |
| 客户端公平性 | 显式考虑欠偿与等待 | 取决于 |
八、复习与推演
- 为什么均分预算可能导致搭便车?
- Shapley值解决了哪种顺序偏差,代价是什么?
分别表示什么? - FLI为什么需要两个队列而不是一个?
增大时支付优先级如何变化? - 为什么FLI的
不代表整个贡献评估是 ? - 哪些行为会操纵贡献或成本?
- 如何判断一个激励机制是否提高长期参与而非短期更新量?
🔍 参考答案
- 无信息或低质量贡献和高质量贡献获得相同回报。
- 它平均所有加入顺序下的边际贡献,但精确计算需要大量子联盟评估。
- 当前贡献、当前成本、累计欠偿、欠偿等待。
- 相同欠款金额下,等待更久者应有更高优先级。
- 更强调当前贡献
,相对弱化历史欠偿。 仅指给定 后的支付计算;求 可能需要多次训练/评估。 - 高报成本、复制身份、针对验证集优化、串谋制造边际价值。
- 观察留存率、真实质量、欠偿分布和预算效率的长期变化,而非只看参与次数。
🧪 从理解到研究(进阶)
已知局限与隐含假设
参与成本
难以估计,可能需采购拍卖; 贡献
难以估计,可能需沙盒模拟; Shapley计算昂贵;
数据质量与成本未必独立,参与方可能提交无信息数据套利。
贡献可由可验证的标量
表示; 成本报价接近真实成本;
参与身份唯一且不可复制;
当前模型改进能代表长期业务价值;
预算长期足以覆盖必要成本。
从假设推导:
- 使用单一验证集定义
会奖励对该验证分布的过拟合; - 成本自报若无激励相容机制,会系统性高报;
- 大预算可缓解欠偿,却不能修复错误贡献度量;
- 公开支付和贡献分数可能泄露参与方数据规模、质量和商业价值。
失效条件实验
本节只列激励机制特有扰动;对照组、独立重复、效用与系统指标统一按实验规范报告。
- 让参与方针对贡献验证集过拟合;
- 注入冗余、互补和冲突数据,比较贡献度量;
- 模拟成本高报、低报和多身份;
- 设置长期预算赤字,观察欠偿队列是否发散;
- 比较平均支付、最差欠偿和高质量参与方留存;
- 加入投毒方,测试“短期提分、长期后门”的支付漏洞。
- 文献佐证:贡献分数的可操纵性与成本谎报、多身份参与是机制设计综述(Zhan et al., A Survey of Incentive Mechanism Design for Federated Learning, IEEE TETC 2022)的核心议题;「支付-真实效用背离」是激励相容研究的直接对象。
可证伪的研究问题
当贡献分数由单一验证集上的即时精度增益定义时,参与方是否能通过针对该验证分布的更新获得高支付,却降低时间外测试集性能;多验证环境的一致性评分能否降低这种支付-泛化背离?
- 现有方法:即时模型改进贡献分数加FLI。
- 失效条件:验证分布固定且可被推断。
- 可能机制:参与方优化支付代理而非真实效用。
- 可观察结果:贡献分、付款、验证/时间外性能和更新相似度。
- 验证指标:支付-真实效用相关系数、长期精度、后门成功率和留存率。
现代研究方向
- 可扩展数据Shapley及近似误差界;
- 隐私保护贡献评估;
- 抗女巫、抗串谋和可验证训练;
- 公平与鲁棒客户端选择的联合机制;
- 联邦基础模型中数据、算力和适配器贡献的定价。
九、章节关系
第4~6章:参与方如何协作训练
  ↓
第7章:参与方为何持续协作
  ├─ 贡献评估依赖模型性能
  ├─ 成本依赖计算/通信/机会成本
  ├─ 安全依赖防虚报和可验证执行
└─ 应用联盟依赖长期治理与预算原始论文与关键后续
- Yu et al., A Sustainable Incentive Scheme for Federated Learning, IEEE Intelligent Systems 35(4), 2020(DOI: 10.1109/MIS.2020.2987774):FLI出处;在给定预算下权衡集体效用、未获支付和等待时间。
- Liu et al., FedCoin: A Peer-to-Peer Payment System for Federated Learning, IEEE TrustCom 2020(arXiv:2002.11711):基于Shapley值、区块链和Proof of Shapley的点对点支付路线,与FLI的队列机制不同。
- Zhan et al., A Survey of Incentive Mechanism Design for Federated Learning, IEEE Trans. Emerg. Top. Comput., 2022:激励机制设计(贡献评估、收益分配、激励相容)综述。