第1章 引言与联邦学习分类
本章先记住
- 联邦学习约束的是数据如何协作,不是某个固定模型或单一算法。
- 判断HFL、VFL、FTL时,只看样本ID与特征空间的重叠关系,不看行业名称。
- 原始数据留在本地仍可能通过梯度、中间激活和最终模型泄露信息。
🧭 学习目标与本章地图
本章定位
- 在知识体系中的位置:给出联邦学习的问题背景、基本定义和分类坐标系。
- 前置知识:监督学习、训练数据、特征、标签、模型评估。
- 后续基础:第4章横向联邦、第5章纵向联邦、第6章联邦迁移学习。
- 核心问题:数据不能直接集中时,多方如何协作训练接近集中式效果的模型?
学习目标
- 解释联邦学习产生的现实动机。
- 准确区分HFL、VFL和FTL。
- 画出客户-服务器和P2P两种架构。
- 说明联邦模型与集中式模型的性能关系。
- 指出“数据不出本地”仍未解决的风险。
Mermaid思维导图
一、本章要解决的问题
集中式机器学习通常要求把训练数据收集到一个位置,但现实中存在四类障碍:
- 法律障碍:敏感数据的收集、处理和跨机构共享受到约束。
- 商业障碍:数据是机构资产,直接交付会造成控制权和竞争优势流失。
- 数据障碍:单个机构的数据规模、特征或标签不足,形成数据孤岛。
- 系统障碍:手机、车辆和传感器生成的数据量大,全部上传成本过高。
联邦学习尝试在这些约束下获得协作收益,但它并不承诺无条件达到集中式学习的效果,也不自动提供完整隐私保证。
二、核心概念与定义
| 概念 | 准确定义 | 通俗理解 | 与相近概念的区别 |
|---|---|---|---|
| 联邦学习 | 多个参与方使用本地数据协作训练模型,训练中原始数据不离开拥有方,模型相关信息受控交换 | 数据不搬家,让计算或模型去协作 | 普通分布式训练通常可由同一控制方任意分片数据 |
| 参与方 | 持有训练数据并参与本地计算的实体 | 手机、医院、银行等 | 不一定是受服务器完全控制的工作节点 |
| 协调方/聚合服务器 | 下发模型、收集并聚合更新、推进训练轮次的角色 | 训练流程的组织者 | 不一定可信,也不一定能查看单个更新 |
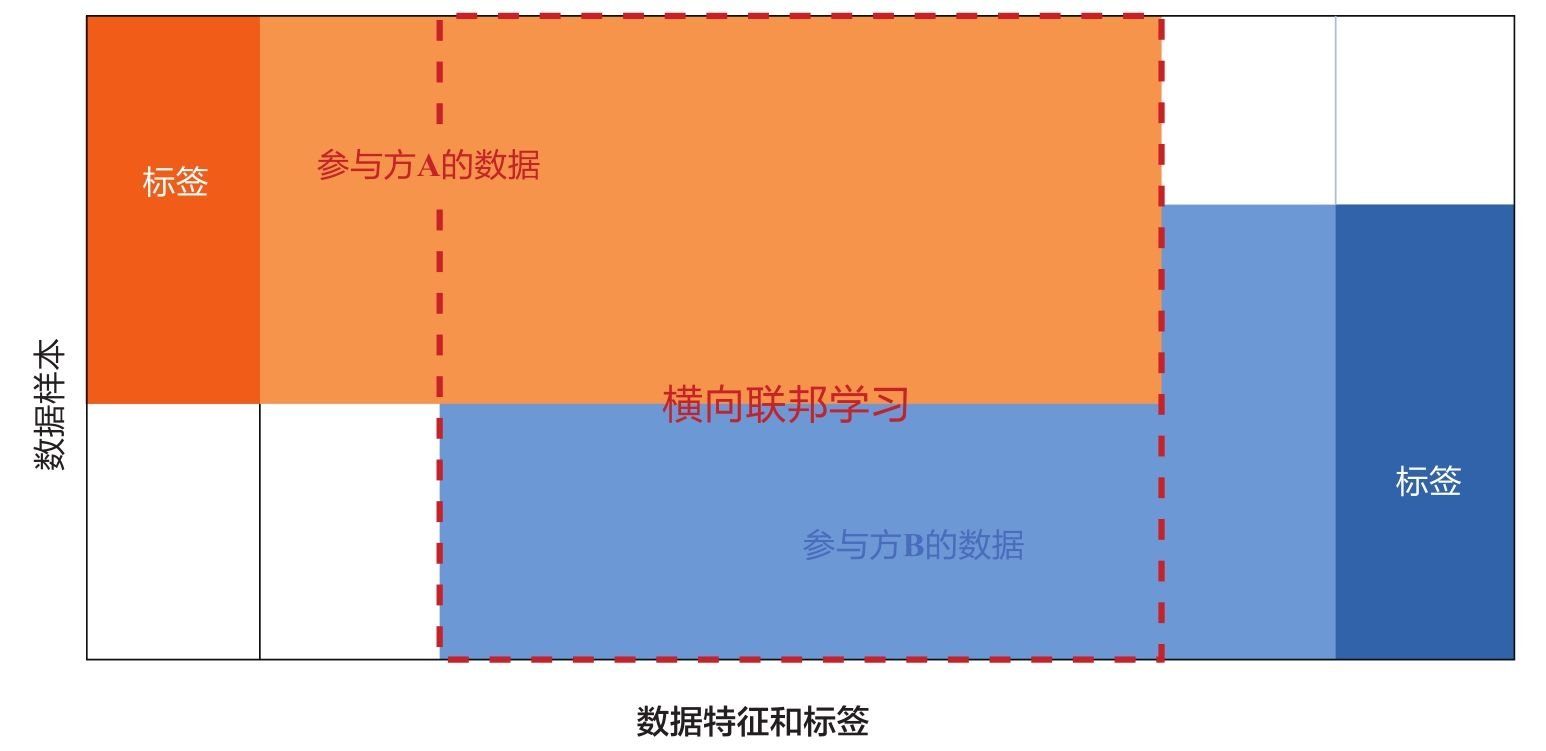
| 横向联邦学习(HFL) | 各方特征和标签空间相同,样本ID不同或重叠很少 | 同样的表头,不同的行 | 主要扩大样本量 |
| 纵向联邦学习(VFL) | 各方拥有大量重叠样本,但特征空间不同 | 相同的行被拆成不同的列 | 主要扩展特征维度,需实体对齐 |
| 联邦迁移学习(FTL) | 样本和特征均少量重叠,通过迁移学习实现知识协作 | 表头和用户都不同,寻找可迁移知识 | 依赖跨域相似性,存在负迁移风险 |
设第
| 类型 | 关系概括 |
|---|---|
| HFL | |
| VFL | |
| FTL |
用三条贯穿案例完成分类
| 案例 | 样本关系 | 特征与标签关系 | 判断 |
|---|---|---|---|
| A:跨医院联合诊断 | 患者不同或重叠很少 | 病历字段和标签语义可对齐 | HFL:同列不同行 |
| B:银行—电商联合风控 | 共同客户较多 | 银行持信用特征和标签,电商持消费特征 | VFL:同行不同列 |
| C:跨地区弱标签迁移 | 共同对象很少 | 字段体系不同,目标域可用监督稀缺 | FTL:依赖可迁移语义 |
按下面的顺序判断,而不是根据行业名称分类:
- 特征接口和标签语义能否对齐?若能、而样本主要不同,优先考虑HFL。
- 共同实体是否足以支撑联合建模?若能、而特征分散,优先考虑VFL。
- 样本和特征都难对齐时,是否存在可验证的跨域语义?若存在,才考虑FTL。
- 若没有足够共同样本,也没有可验证的迁移联系,当前数据条件可能不适合联邦联合建模。
三、核心机制
客户端-服务器架构
text
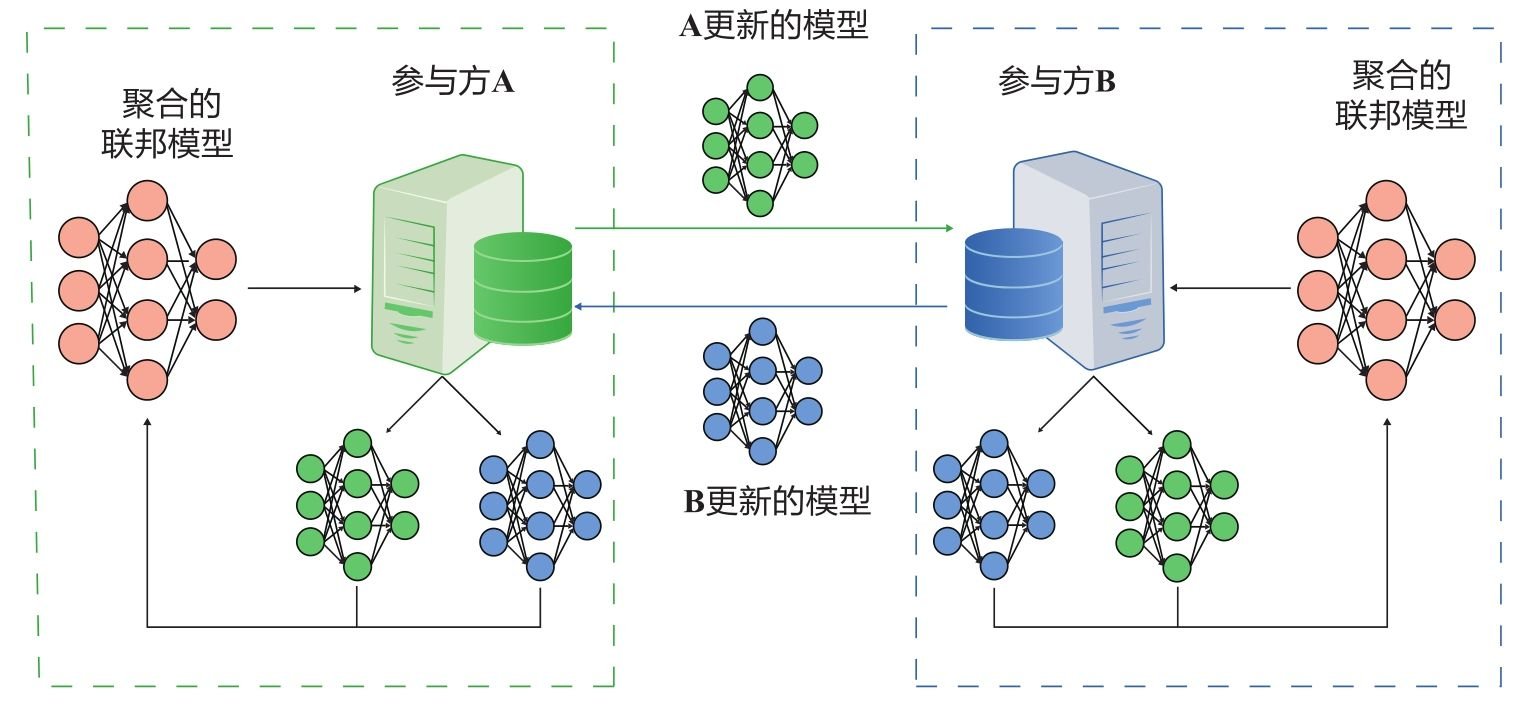
服务器初始化模型
  ↓
参与方用各自本地数据训练
  ↓
参与方上传模型更新(必要时加密或掩码)
  ↓
服务器聚合更新
  ↓
服务器下发新模型并进入下一轮- 输入:各方私有数据、初始模型、训练配置。
- 角色:参与方和聚合服务器。
- 交换内容:模型参数、梯度或受保护的中间结果,而非原始数据。
- 输出:共享模型,或分布于多方的模型组件。

P2P架构
没有固定中央服务器,参与方按约定次序或网络拓扑直接交换模型信息。它移除了中心协调点,但带来拓扑设计、一致性、容错和更多通信问题。
训练与推理
- HFL通常可以把完整全局模型部署到客户端,单方执行推理。
- VFL和部分FTL的模型或特征分散在各方,推理时仍可能需要多方协作。
四、关键性能关系
记集中参考模型为
表示为隐私、数据主权和系统约束付出的可接受效用损失;它不同于差分隐私中的 。 - 该关系是目标性定义,不表示所有联邦算法都能自动满足。
- 现代研究还需要评价公平性、通信成本、隐私预算和安全性,不能只比较平均精度。
五、关键假设
| 假设类型 | 具体假设 | 假设不成立时的后果 |
|---|---|---|
| 数据假设 | 能明确样本、特征和标签的分布关系 | 选错HFL/VFL/FTL范式,协议无法工作 |
| 系统假设 | 参与方能完成必要通信和本地计算 | 掉线、延迟或资源差异阻断训练 |
| 模型假设 | 各方对任务、模型接口和评价目标有共识 | 参数无法聚合或收益无法共享 |
| 信任假设 | 各角色至少遵守某种协议或可被约束 | 伪造更新、泄露中间结果或拒绝服务 |
| 攻击者假设 | 需要明确服务器、客户端是否半诚实或恶意 | 无法判断隐私与安全声明是否成立 |
六、代价与权衡
| 维度 | 收益 | 代价或风险 |
|---|---|---|
| 模型效果 | 利用多方数据改善模型 | Non-IID可能导致偏差或不收敛 |
| 本地计算 | 计算靠近数据,减少原始数据上传 | 终端算力和能耗压力增加 |
| 通信成本 | 不传全部原始数据 | 多轮模型通信仍可能昂贵 |
| 隐私 | 降低原始数据直接暴露 | 更新和最终模型仍可能泄露信息 |
| 安全 | 可组合密码协议 | 恶意参与方仍可投毒或欺骗 |
| 公平 | 多方可以共享模型收益 | 大数据方可能主导模型和收益 |
七、复习与推演
- 联邦学习为什么不仅是“把SGD分布化”?
- HFL、VFL和FTL的判别坐标是什么?
- 客户端-服务器与P2P架构各有什么代价?
- 为什么VFL在推理时也可能需要多方参与?
性能损失表达的是什么目标? - 为什么数据不出本地不等于隐私安全?
🔍 参考答案
- FL还包含数据主权、Non-IID、部分参与、通信限制、隐私和不完全信任等约束。
- 看样本ID空间与特征空间的重叠关系。
- 前者容易编排但有中心信任和单点问题;后者移除固定中心但一致性、容错和通信更复杂。
- 因为模型组件和新样本特征分别位于不同参与方。
- 联邦模型在不集中数据时应尽量接近集中式模型,但允许为约束付出有限效用代价。
- 梯度、参数、中间激活和模型输出都可能泄露训练信息。
🧪 从理解到研究(进阶)
已知局限与隐含假设
通信连接慢且不稳定。
数据Non-IID且数量不平衡。
大量参与方难以认证和管理。
恶意更新可能破坏全局模型。
需要公平、可持续的收益分配机制。
参与方可以被稳定归入某种数据划分类型。
参与方愿意遵守协议并持续在线。
全局平均性能可以代表多方收益。
联邦模型与集中式模型的差距可被单一指标表达。
从假设推导:
- “数据留在本地”无法防止梯度反演和成员推断。
- 如果参与概率与数据分布相关,训练样本并非随机代表总体。
- 单一共享模型可能牺牲少数客户端。
失效条件实验
本节只列分类与架构特有扰动;对照组、独立重复、统计和复现信息统一按实验规范报告。
- 让参与概率与客户端标签分布相关;
- 同时加入标签偏移、特征偏移和数据量不平衡;
- 比较平均性能与最差客户端性能;
- 模拟新客户端加入、旧客户端退出和时间漂移;
- 在相同任务中比较客户-服务器与去中心化架构。
可证伪的研究问题
当少数群体客户端的在线概率显著低于主流客户端时,按样本量聚合是否会造成超过其数据占比所能解释的性能损失?
可观察结果:群体精度、参与频率、更新方向和最差客户端性能;基线包括均匀参与、重加权参与和本地训练。
现代研究方向
- 个性化与客户端公平;
- 非IID与鲁棒聚合的冲突;
- 动态参与和概念漂移;
- 模型异构与联邦基础模型;
- 联邦遗忘、审计和端到端隐私。
八、章节关系
text
第1章定义与分类
  ├─ 第2章:如何形式化隐私和攻击者
  ├─ 第3章:分布式训练基础
  ├─ 第4章:HFL与FedAvg
  ├─ 第5章:VFL与安全协同计算
└─ 第6章:FTL与共享表征原始论文与关键后续
- Yang et al., Federated Machine Learning: Concept and Applications, ACM TIST 10(2), 2019(arXiv:1902.04885):提出 HFL / VFL / FTL 三类划分,本专题分类沿用此框架。
- Kairouz et al., Advances and Open Problems in Federated Learning, Found. Trends Mach. Learn. 14(1-2), 2021(arXiv:1912.04977):联邦学习全景综述,覆盖数据异质性、隐私、鲁棒聚合与系统问题,是全局视野的首选入口。
- Li et al., Federated Learning: Challenges, Methods, and Future Directions, IEEE Signal Processing Magazine 37(3), 2020(arXiv:1908.07873):应用视角综述,术语与本文一致。