第4章 横向联邦学习与FedAvg
本章先记住
- FedAvg让客户端在两次通信之间执行多步本地训练,再按样本量聚合。
- 多做本地训练可以减少通信轮次,也会在Non-IID下放大客户端漂移。
- FedProx、SCAFFOLD、FedNova、FedOpt和FedDyn分别修改本地目标、本地梯度、更新归一化、服务器优化器和动态正则状态。
- FedBN保留本地BN状态,Per-FedAvg学习可快速适配的共享初始化;它们的输出不再是一个完全统一的部署模型。
- 原始FedAvg没有正式隐私保证;安全聚合、HE和DP解决的是不同问题。
🧭 学习目标与本章地图
本章定位
- 在知识体系中的位置:三类联邦学习算法主线的第一章,从第3章数据并行过渡到数据自治条件下的联邦优化。
- 前置知识:SGD、数据并行、参数服务器、Non-IID、AHE与安全聚合。
- 后续基础:联邦优化、个性化FL、鲁棒聚合和联邦大模型训练都以FedAvg为重要基线。
- 核心问题:特征相同、样本分散时,如何用更多本地计算换更少通信,并限制服务器看到单个更新?
学习目标
- 闭卷写出FedSGD与FedAvg伪代码。
- 解释梯度平均与模型平均何时等价。
- 说明
、 、 、 对训练的影响。 - 从目标函数解释Non-IID为何造成客户端漂移。
- 区分安全FedAvg、安全聚合和差分隐私。
- 根据失败来源选择FedProx、SCAFFOLD、FedNova、FedOpt或FedDyn。
- 区分共享模型优化、局部状态保留和个性化初始化。
- 分析参与方选择、压缩和异步训练的偏差。
Mermaid思维导图
一、本章要解决的问题
横向联邦的各方拥有相同的特征/标签结构,却拥有不同记录。集中训练可直接混合样本;联邦训练不能移动原始数据,还面对四个典型的优化约束:
- 数据通常Non-IID;
- 客户端数据量不平衡;
- 参与方数量可能非常大;
- 上行慢、连接不稳定且客户端会掉线。
由于通信通常比本地计算昂贵,核心策略是让每次通信承载更多本地计算结果。但本地训练越充分,局部目标之间的差异也越容易把模型拉向不同方向。
⭐ 核心结论
FedAvg的关键不是“平均”本身,而是把多步本地优化放在两次通信之间。它以本地计算换通信轮次;当各客户端局部目标差异大时,这个交换会同时放大客户端漂移。
二、核心概念与定义
| 概念 | 准确定义 | 通俗理解 | 与相近概念的区别 |
|---|---|---|---|
| 横向联邦学习(HFL) | 各方特征与标签空间相同,样本ID空间不同或重叠很少 | 同表头、不同记录 | 纵向联邦是相同用户的不同字段 |
| 联邦优化 | 在数据自治、Non-IID、部分参与和通信受限条件下优化全局目标 | 不能随意洗牌数据的分布式优化 | 数据中心通常可控制分片和节点 |
| FedSGD | 每轮选中客户端在本地全部数据上计算一次梯度,服务器聚合 | 一次本地梯度后通信 | FedAvg会做多个批次/多轮本地更新 |
| FedAvg | 客户端从同一全局参数出发做多步本地SGD,服务器按数据量平均模型 | 各自在本地走几步,再汇合 | 多步后模型平均通常不等于单次梯度平均 |
| 客户端漂移 | 本地更新因局部目标与全局目标不一致而偏向客户端自身最优方向 | 各客户端越走越向自己的目标偏离 | 不只是随机梯度噪声 |
| 安全聚合 | 服务器只得到选中客户端更新的聚合值,不见单个更新 | 只看总和 | 不限制聚合值/最终模型泄露,不提供投毒防御 |
| 梯度平均 | 服务器聚合客户端在同一参数点计算的梯度 | 平均“方向” | 单步同步时可与模型平均等价 |
| 模型平均 | 服务器聚合客户端本地更新后的参数 | 平均“位置” | 多步、本地优化器状态或非线性目标下差异明显 |
HFL的数据条件
令
这里的“相同”指参与共同任务所需的数据模式对齐;样本ID可完全不交或交集很小。
贯穿案例A:跨医院联合诊断
| 统一问题 | 本案例的回答 |
|---|---|
| 参与方是谁? | 医院A、医院B和聚合服务器;两家医院都提供数据与本地计算 |
| 数据如何分布? | 两院使用对齐的检查字段和标签语义,但患者不同;每院在本地持有特征和标签 |
| 交换什么? | 服务器下发全局模型;医院上传模型差值、梯度或其受保护形式 |
| 谁能看到什么? | 医院看到本地数据和全局模型;服务器能看到什么取决于是否使用安全聚合或加密 |
| 模型归谁? | 通常形成完整共享模型,但部署权、审计权和更新权仍需协议约定 |
| 推理依赖谁? | 模型完整下发后,单家医院通常可以独立预测 |
| 哪个假设最脆弱? | 两院标签标准一致且参与样本能代表目标患者;设备、地区或患者结构偏移会破坏该假设 |
| 与谁比较? | A-only与B-only(两院各自的Local-only)、可行的集中参考、FedSGD,以及同预算下不同本地步数/权重的FedAvg |
三、核心机制
3.1 客户-服务器架构
服务器初始化并下发全局模型
  ↓
本轮客户端在本地数据上计算梯度或更新参数
  ↓
客户端上传明文/掩码/密文更新
  ↓
服务器聚合梯度或模型
  ↓
服务器下发聚合结果
  ↓
重复至收敛、轮次或时间上限该流程的角色、持有状态、消息、终止条件和复杂度统一收录在算法卡片;本章下面只展开聚合为什么成立、何时不再等价,以及参数如何改变训练行为。

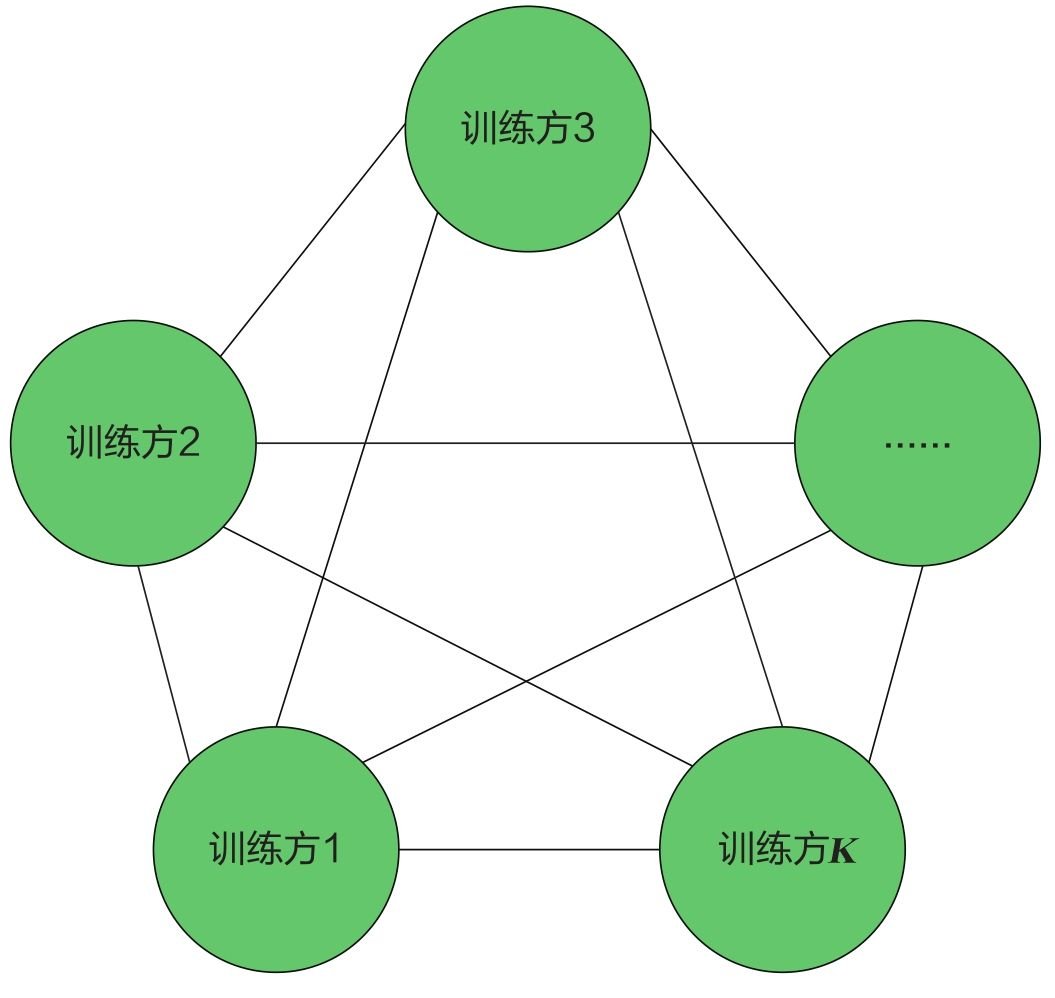
3.2 P2P架构
中心节点选择客户端、下发模型并聚合。编排和全局评估直接,但服务器是信任、隐私和可用性集中点。
| 维度 | 客户-服务器 | P2P |
|---|---|---|
| 协调 | 中央服务器 | 预定链或随机邻居 |
| 聚合 | 并行收集后聚合 | 参数沿网络传播 |
| 中心风险 | 有 | 无固定中心 |
| 主要代价 | 中心信任、带宽、单点 | 拓扑、顺序、一致性、容错 |
3.3 全局模型评估
各客户端在本地测试集计算
不能直接平均各客户端召回率,否则小测试集与大测试集权重相同。即便聚合计数正确,平均性能仍不能替代最差客户端、分位数和群体指标。
四、关键公式
4.1 有限和目标
将所有训练样本写成有限和,可得到全局经验风险:
是 维模型参数, 是总样本数。 - 对监督学习,
是样本 的损失。 - 它优化所有样本的平均风险。
令第
是客户端 的局部目标, 是其样本权重。 - IID时,
可望近似 ;Non-IID时, 可能系统性偏离 。 - 数据量加权优化的是样本平均目标,不等于客户端公平目标。
若第
全体参与时
4.2 梯度平均
客户端在共同参数
其中
4.3 模型平均
客户端先在本地执行一步更新:
服务器再按样本量聚合本地模型:
将本地一步更新代入模型聚合公式,即可得到加权梯度更新。因此,同一初始点、一步相同学习率的本地更新下二者等价。多步更新后,各客户端梯度在不同参数点计算,通常不再等价。
💡 贯穿案例A:走完一轮两步FedAvg
为突出计算过程,把诊断模型简化成一个标量参数(教学构造示例:数值仅为演示计算逻辑而设计,不代表真实训练数据或结果)。医院A有100名患者,医院B有300名患者;服务器下发共同初始值
| 阶段 | 医院A | 医院B |
|---|---|---|
| 初始参数 | ||
| 第一步局部梯度 | ||
| 第一步后 | ||
| 第二步局部梯度 | ||
| 上传的本地参数 |
服务器按本轮样本量归一化:
若改成客户端均匀加权,则
这两个局部目标只用于演示消息和计算,不代表真实诊断损失。第二步梯度分别在
和 处计算,因此多步模型平均不能再化成共同参数点上的一次梯度平均。
4.4 参数影响
| 参数 | 含义 | 增大时的主要收益 | 增大时的主要风险 |
|---|---|---|---|
| 每轮参与客户端比例 | 聚合覆盖更多数据、方差可能降低 | 通信和慢节点等待增加 | |
| 每轮本地训练遍数/步骤控制量 | 单轮学习更多、可能减少通信轮次 | Non-IID漂移、过拟合和计算增加 | |
| 本地mini-batch大小 | 梯度方差降低、并行效率可能提高 | 每步算力/内存增加;更新次数减少 | |
| 学习率 | 加快局部进展 | 振荡、发散和漂移放大 |
若
实际实现需对非整除、最后一个批次及
💡 完整算法卡(数据划分/角色/复杂度/隐私/信任假设/失效条件)见 09 算法卡片。
五、FedSGD、FedAvg与现代优化
5.1 FedSGD与FedAvg
设置
| 维度 | FedSGD | FedAvg |
|---|---|---|
| 每轮本地工作 | 一次全本地梯度 | 多批次/多步SGD |
| 上传内容 | 梯度 | 模型或更新差值 |
| 通信轮数 | 通常更多 | 通常更少 |
| 客户端漂移 | 较弱 | 随本地步数和异质性增强 |
| 对本地算力要求 | 较低 | 较高 |
💡 通俗理解
若每个客户端的局部损失像朝不同方向倾斜的山谷,FedSGD只在同一个出发点各看一次坡度;FedAvg让各客户端沿自己的山谷走多步再平均位置。走得越久,位置分歧通常越大。
5.2 先诊断失败来源
五种现代方法不是同一个问题的五种写法。选择前先看“偏差从哪里进入更新”:
| 观察到的失败 | 主要来源 | 对应方法 | 改动位置 |
|---|---|---|---|
| 本地模型远离本轮全局起点 | 局部目标与全局目标冲突 | FedProx | 本地目标 |
| 相同起点下,各客户端梯度方向持续偏离全局方向 | 客户端漂移 | SCAFFOLD | 本地梯度与控制状态 |
| 快客户端或大数据客户端执行更多本地步后被隐式放大 | 本地步数/求解器不一致 | FedNova | 上传更新的归一化与服务器步长 |
| 聚合方向可用,但服务器SGD难调或收敛不稳 | 服务器优化器能力不足 | FedOpt | 服务器更新 |
| 各客户端把自己的局部目标解得很好,但局部驻点与全局驻点不一致 | 局部与全局驻点不一致 | FedDyn | 随轮次更新的本地线性项、二次项与服务器状态 |
5.3 FedProx:限制本地解偏离全局起点
FedProx把客户端
其梯度为
⚡ 参数边界
5.4 SCAFFOLD:用控制变量校正客户端漂移
SCAFFOLD维护服务器控制变量
其中
这里
5.5 FedNova:先归一化本地进度,再决定全局步长
令客户端
对普通本地SGD,FedNova先得到归一化方向:
再把方向权重与全局有效步长分开:
因此,多做本地步不再自动意味着该客户端方向在聚合中权重更大。更一般的本地求解器需要用其梯度累积系数的
⚡ 目标边界
FedNova修正的是本地进度不同造成的目标不一致,不会让彼此冲突的
5.6 FedOpt:把聚合模型差当作服务器伪梯度
记客户端模型差及其加权平均为:
FedOpt把
服务器使用SGD且
5.7 FedDyn:用动态正则对齐局部与全局驻点
FedDyn针对“全局梯度之和为零,但单个客户端梯度通常不为零”的不一致。按原论文的客户端均匀目标,客户端
客户端只上传本地模型
⚡ 目标与定位边界
FedDyn原论文优化
5.8 组合关系与选择顺序
| 方法 | 首先扫描的参数/状态 | 额外代价 | 与其他路线的关系 |
|---|---|---|---|
| FedProx | 本地近端梯度 | 可与服务器优化器组合,但需重新公平调参 | |
| SCAFFOLD | 客户端状态与 | 修正漂移;不能把现成收敛结论直接套到任意组合 | |
| FedNova | 记录并上传归一化信息 | 原论文明确可配合不同本地求解器和服务器优化器 | |
| FedOpt | 客户端学习率、服务器学习率、动量/自适应状态 | 服务器状态与调参 | 改服务器步,不自动修正本地方向偏差 |
| FedDyn | 客户端与服务器持久状态 | 动态对齐局部/全局驻点;不是个性化输出 |
方法作用于不同层面不代表可以无条件叠加。组合实验必须写清最终优化目标、状态归属和更新顺序,并重新比较通信、计算与调参预算。
六、共享模型、局部状态与个性化输出
6.1 先明确最终部署什么
FedAvg、FedProx、SCAFFOLD、FedNova、FedOpt和FedDyn的主要目标都是训练一个共享模型。个性化联邦学习则允许客户端最终部署不同参数或状态。在选方法前,先写清下列输出之一:
| 输出形态 | 典型做法 | 联邦阶段学什么 | 部署时还需要什么 |
|---|---|---|---|
| 单一共享模型 | FedAvg与联邦优化变体 | 完整全局参数 | 直接下发,可选后续微调 |
| 共享主干+本地模块 | 本地分类头、FedBN | 只聚合共享部分 | 客户端持有本地头或BN状态 |
| 全局/本地模型混合 | 插值或自适应混合 | 全局模型与混合规则 | 本地模型和混合权重 |
| 客户端簇/多任务模型 | 聚类或联邦多任务学习 | 多个相关模型或任务关系 | 客户端归属与本地参数 |
| 可快速适配的初始化 | Per-FedAvg | 元初始化 | 客户端使用本地数据做少量适配 |
“FedAvg训练完再本地微调”是必须保留的强基线;否则无法判断收益来自个性化目标,还是只来自额外的本地训练。
6.2 FedBN:在特征偏移下保留本地归一化
将模型状态分为非BN共享参数
⚡ 适用边界
FedBN针对的是特征分布偏移,不是所有标签偏斜、概念偏移或恶意更新。没有BN层的架构不能直接应用该机制;本地batch太小时,BN统计又可能高方差。新客户端没有历史
6.3 Per-FedAvg:学习适配后表现良好的初始化
FedAvg直接最小化各客户端在同一个
联邦阶段学到的
精确元梯度包含Hessian项:
因此实验必须区分使用Hessian信息的版本和忽略/近似二阶项的一阶版本,并对齐梯度计算、batch数与墙钟预算。
6.4 个性化评估不能只报一个平均精度
| 评估切片 | 回答的问题 |
|---|---|
| 适配前 vs. 适配后 | 元初始化或共享模型是否真的容易个性化? |
| 训练期已见 vs. 新客户端 | 方法是记住参与者,还是能迁移到新客户端? |
| 平均 vs. 分位数/最差客户端 | 收益是否以牺牲尾部客户端为代价? |
| 不同本地样本量 | 少样本客户端是否因适配方差过大而受损? |
| 相同适配步数/调参预算 | 优势是否只来自更多本地计算? |
最少应比较Local-only、未适配的FedAvg、FedAvg+相同预算本地微调,以及所提个性化方法。FedBN还应比较“聚合BN”与“本地BN”;Per-FedAvg应单独扫描适配步数和内层学习率。
七、安全FedAvg与隐私边界
客户端可以上传密文或受掩码更新,使服务器只获得允许的聚合结果;这改变消息的可见性与系统成本,不改变FedAvg优化目标本身。AHE安全FedAvg的消息流见算法卡片,安全聚合、HE和DP的正式边界见隐私机制卡片。
⚡ 隐私边界
安全FedAvg不是“FedAvg天然安全”。原始FedAvg上传明文更新;安全聚合只隐藏单个更新;差分隐私限制邻接关系所声明保护单位对输出的影响。单条病历、单名患者和整家医院分别对应记录级、用户级与机构级目标,不能混称。
八、关键假设
| 假设类型 | 具体假设 | 假设不成立时的后果 |
|---|---|---|
| 数据假设 | 特征/标签接口一致;样本可映射到共同任务 | 模型参数无法直接聚合 |
| 数据假设 | 谎报数据量或选择偏差扭曲更新 | |
| 个性化假设 | 客户端有足够且代表部署分布的本地适配数据 | 本地微调或BN校准高方差、过拟合 |
| 系统假设 | 每轮有足够客户端在线且完成上传 | 同步轮次阻塞,安全聚合可能低于阈值 |
| 模型假设 | 客户端从相同参数和兼容优化设置出发 | 参数平均失去语义 |
| 信任假设 | 基础分析通常假设客户端诚实、服务器半诚实 | 恶意客户端可投毒、植入后门或伪报指标 |
| 攻击者假设 | AHE/安全聚合的密钥与串谋阈值成立 | 单个更新可能被恢复 |
九、代价与权衡
| 维度 | 收益 | 代价或风险 |
|---|---|---|
| 模型效果 | 融合更多样本 | Non-IID与选择偏差导致漂移和群体损失 |
| 本地计算 | 多算少通信 | 能耗、热量和低端设备负担 |
| 通信成本 | 本地多步减少轮数 | 每轮仍上传 |
| 存储成本 | 本地保留数据 | 模型与优化器状态占设备空间 |
| 隐私保证 | 可叠加AHE/安全聚合/DP | 隐私不是原始FedAvg属性 |
| 安全与鲁棒性 | 隐藏更新降低窥探 | 隐藏后更难逐客户端检测投毒 |
| 客户端公平性 | 数据量加权优化样本平均 | 大数据方主导,尾部客户端被牺牲 |
| 个性化 | 允许客户端适配本地分布 | 增加本地状态、训练成本与新客户端冷启动问题 |
十、复习与推演
- HFL的数据空间关系是什么?
- 从有限和目标推导客户端加权目标。
- 闭卷写出FedAvg的一轮服务器端和客户端步骤。
- FedSGD与FedAvg的差别是什么?
- 梯度平均和模型平均何时等价?
- 为什么增大
既可能减少通信又可能恶化收敛? - 安全聚合为什么不等于差分隐私?
- 为什么基于速度选客户端可能损害公平?
- 贯穿案例A中,样本量加权和医院均匀加权分别得到什么结果?若医院B掉线,本轮训练分布发生了什么变化?
- FedDyn与FedProx都有二次项,为什么不是同一个方法?
- FedBN为什么不能被概括为“解决所有Non-IID”?
- Per-FedAvg训练的
与客户端最终部署的 有何不同?
🔍 参考答案
- 特征和标签空间一致,样本ID不同或重叠很少。
- 将总样本按客户端索引集分组,得到
。 - 采样并下发
;客户端多步本地SGD并上传;服务器按样本权重平均得到 。 - FedSGD在共同参数点计算一次全本地梯度;FedAvg执行多步本地更新后平均模型。
- 客户端从同一参数出发,只做一步、学习率一致且服务器采用相同权重时。
- 本地多算让每轮进展增加,但局部目标不同会让轨迹分叉。
- 前者隐藏单个更新;后者限制单个样本/用户对输出分布的影响。
- 设备速度可能与地区、群体和数据分布相关,使抽样不再代表目标总体。
- 样本量加权得到
,医院均匀加权得到 ;B掉线且按参与方重新归一化时只得到A的 ,本轮有效数据从400名患者变成只代表A院的100名患者。 - FedProx只用与本轮全局起点的距离限制偏移;FedDyn还有由历史局部梯度更新的线性项和服务器校正状态,目标是对齐局部与全局驻点。
- FedBN只直接针对可由本地BN吸收的特征分布偏移;标签偏斜、概念偏移、无BN架构和过小batch都需单独处理。
是联邦训练学到的可适配初始化;部署模型 还使用了客户端 的本地数据,因而各客户端可以不同。
🧪 从理解到研究(进阶)
已知局限与隐含假设
无法查看分布式数据使超参数和优化器选择困难;
通信开销随模型、客户端和轮次增长;
需要激励机构和移动用户参与;
参与方可谎报数据量或测试结果;
掉线、动态加入和不同可靠度需要更灵活机制;
一般非凸目标下模型平均可能得到差模型或不收敛。
⚠️ 不能仅凭名称假定某后续方法(FedProx/SCAFFOLD/FedNova/FedOpt/FedDyn/FedBN/个性化FL)在所有 Non-IID、掉线、安全或公平条件下都优于 FedAvg,必须在相同参与率、计算量和调参预算下验证。
客户端采样近似代表目标总体;
可验证且样本量加权符合业务目标; 本地计算步数的收益大于漂移代价;
更新保护与异常检测可以同时实现;
单一全局模型是所有客户端可接受的输出。
从假设推导:
- 基于速度的客户端选择会把系统效率问题变成统计抽样偏差;
- 按样本量加权不保证客户端公平;
- 安全聚合隐藏更新后,鲁棒聚合所需的逐客户端可见性受到限制;
- 全局混淆矩阵仍可能泄露小客户端的标签分布,应设阈值或保护统计量。
失效条件实验
本节只列FedAvg特有扰动;数据划分、对照组、独立重复与结果指标统一按实验规范报告。
- 用Dirichlet标签划分逐步增强Non-IID;
- 让慢客户端集中持有少数类,比较随机与速度优先选择;
- 网格改变
、 和参与率 ; - 设置客户端数据量长尾并比较样本加权与客户端均匀加权;
- FedProx联合扫描
与本地步数,检查稳定性是否来自更强约束而非更多调参; - SCAFFOLD改变参与率和客户端重访间隔,报告控制变量陈旧度、额外状态及通信量;
- FedNova逐步增大
方差,比较归一化前后的有效聚合权重与目标偏差; - FedOpt分别扫描客户端学习率、服务器学习率和自适应参数,并与同等调参预算的FedAvgM比较;
- FedDyn扫描
与本地求解精度,同时比较客户端均匀与样本量加权目标,不把目标改变误当成优化收益; - FedBN分别构造特征偏移与标签偏斜,消融BN状态是否本地保留,并扫描本地batch大小;
- Per-FedAvg分开报告适配前/后、已见/新客户端,与FedAvg+同步数微调比较,并对齐元梯度计算预算;
- 同时加入掉线、安全聚合和模型投毒;
- 公平比较:固定客户端采样序列、总本地梯度计算量、通信轮数和超参数搜索预算;同时报告达到目标性能的轮数、总字节数和墙钟时间。
- 文献佐证:FedProx与SCAFFOLD分别从近端约束和控制变量处理异质性;FedNova修正不同本地进度的目标不一致;FedOpt改造服务器优化步;FedDyn动态对齐局部/全局驻点;FedBN保留本地归一化;Per-FedAvg学习少步适配后的初始化。它们的目标、输出与预算不同,不能跨设置直接排名。
可证伪的研究问题
在设备速度与标签分布相关的Non-IID环境中,速度优先客户端选择是否会在相同墙钟时间内提高平均精度,却显著降低最差十分位客户端精度?
- 现有方法:FedAvg加速度优先选择。
- 失效条件:慢客户端持有稀有标签。
- 可能机制:系统选择偏差改变有效训练分布。
- 可观察结果:参与频次、有效标签分布、更新方向、平均/尾部精度。
- 验证指标:墙钟时间、通信量、平均精度、最差十分位精度和群体差距。
现代研究方向
- 组合局部目标、进度归一化与服务器优化时,建立不依赖单一论文假设的收敛与公平评估;
- 研究小样本、新客户端和概念漂移下的个性化冷启动与持续适配;
- 在安全聚合、鲁棒异常检测和客户端隐私之间设计可组合协议。
原始论文与关键后续
- McMahan et al., Communication-Efficient Learning of Deep Networks from Decentralized Data, AISTATS 2017(arXiv:1602.05629):FedAvg 出处;多步本地训练 + 样本量加权聚合。
- Li et al., Federated Optimization in Heterogeneous Networks, MLSys 2020(arXiv:1812.06127):FedProx 出处,近端正则化缓解异质性漂移。
- Karimireddy et al., SCAFFOLD: Stochastic Controlled Averaging for Federated Learning, ICML 2020(arXiv:1910.06378):控制变量估计客户端漂移,方差缩减型代表。
- Wang et al., Tackling the Objective Inconsistency Problem in Heterogeneous Federated Optimization, NeurIPS 2020(arXiv:2007.07481):FedNova 出处,归一化本地累计更新以修正目标不一致。
- Reddi et al., Adaptive Federated Optimization, ICLR 2021(arXiv:2003.00295):FedOpt 出处,把模型差视为服务器伪梯度,并给出FedAdagrad、FedAdam和FedYogi。
- Acar et al., Federated Learning Based on Dynamic Regularization, ICLR 2021(arXiv:2111.04263):FedDyn 出处,用动态线性项和二次项对齐局部共识点与全局驻点。
- Li et al., FedBN: Federated Learning on Non-IID Features via Local Batch Normalization, ICLR 2021(arXiv:2102.07623):FedBN 出处,在特征偏移下保留客户端BN状态。
- Fallah et al., Personalized Federated Learning with Theoretical Guarantees: A Model-Agnostic Meta-Learning Approach, NeurIPS 2020(arXiv:2002.07948):Per-FedAvg 出处,学习少量本地梯度步后表现良好的共享初始化。
- Bonawitz et al., Practical Secure Aggregation for Privacy-Preserving Machine Learning, CCS 2017(arXiv:1611.04482):安全聚合出处(掩码 + 秘密共享 + 掉线恢复)。
- Aji & Heafield, Sparse Communication for Distributed Gradient Descent, EMNLP 2017(arXiv:1704.05021):梯度稀疏化出处(只上传大幅值)。
- Alistarh et al., QSGD: Communication-Efficient SGD via Gradient Quantization and Encoding, NeurIPS 2017(arXiv:1610.02132):梯度量化与编码方法出处。